

L'agentic coding ne réinvente pas l'ingénierie logicielle, il la rend obligatoire
Des tests fiables, une architecture explicite, des builds reproductibles, des changements petits et réversibles, une documentation qui sert vraiment. Je défends ces idées depuis des années, et elles passaient parfois pour du perfectionnisme. (Quand on est poli.)
Avec les agents de code, la discussion est close : ce ne sont plus des préférences d'équipe, c'est la condition pour que l'outil fonctionne.
C'est ce que je constate sur le terrain, et c'est ce que raconte aussi la communauté qui utilise ces outils intensivement. Voici ce qui en ressort, avec les désaccords qui restent ouverts.
Un agent, c'est d'abord une boucle
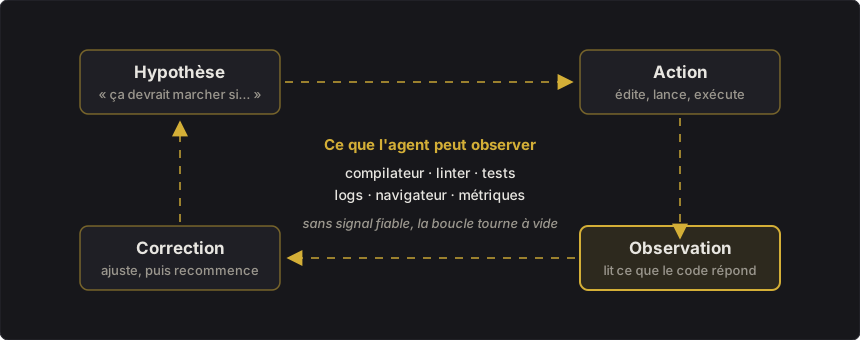
Un assistant classique propose du code, on le relit, on le corrige. Un agent agit : il lit le dépôt, lance des commandes, exécute les tests, observe le résultat et corrige. Un modèle qui n'exécute jamais son code reste dans le plausible. Un agent qui peut vérifier ce qu'il produit entre dans un cycle d'hypothèse, d'action, d'observation et de correction.
C'est un peu le rémoulage d'une lame : on dégrossit, on contrôle le fil, on corrige, et on recommence. Sans contrôle du fil, on affûte à l'aveugle.
Simon Willison, qui documente ces pratiques sous le nom d'agentic engineering, en fait le critère qui distingue l'agent : il exécute le code qu'il écrit. Le prompt compte toujours, mais la qualité du résultat dépend surtout de ce que l'agent peut observer.
Donner à l'agent quelque chose à observer
La question à se poser est simple : si l'agent modifie quelque chose, comment sait-il que ça marche ? Compilateur, tests, logs, navigateur, métriques : plus ces signaux sont fiables et rapides, plus la boucle est efficace.
Un compilateur strict et un linter intransigeant, c'est du feedback gratuit. Et ils ne se lassent jamais de répéter la même remarque. Sur un projet Rust, trois commandes suffisent à cadrer un agent :
cargo fmt --check
cargo clippy -- -D warnings
cargo test
Un développeur humain en tire le même bénéfice. Ce qui change, c'est qu'un projet sans ce filet ne fait plus seulement perdre du temps à l'équipe : il rend l'agent dangereux.
Le dépôt est une interface, et la documentation aussi
Un dépôt a toujours été une interface pour les humains qui arrivent dans l'équipe. C'est maintenant aussi une interface pour les agents : comment démarrer, comment lancer les tests, où est la logique métier, quelles conventions comptent vraiment. Un humain compense une documentation médiocre avec son expérience et ses collègues. Un agent, lui, compense avec des suppositions, et avec beaucoup d'aplomb. (J'en parlais déjà dans La dette de documentation.)
Le fichier d'instructions (AGENTS.md, CLAUDE.md) illustre bien cette convergence. Une étude qualitative de Google auprès de 12 développeurs montre qu'il joue un double rôle : instructions pour l'IA et documentation d'onboarding pour les humains. Elle montre aussi que les 12 valident leurs règles « au feeling », sans évaluation formelle. L'échantillon est petit, mais cela rejoint la mise en garde de Birgitta Böckeler (Thoughtworks) : le context engineering n'a pas de tests unitaires et reste probabiliste. Son conseil : construire ces règles progressivement plutôt que de tout déverser d'un coup, et ne jamais parler de « garantie » quand on écrit une instruction.
Autrement dit, on retrouve ce qu'on disait de la documentation humaine : courte, vivante, maintenue.
Ce qui compte doit être vérifiable par une machine
Une règle qui doit toujours être respectée ne devrait pas vivre uniquement dans un fichier Markdown. « Le module billing ne dépend jamais de web » peut s'écrire dans les instructions, ou faire échouer la CI. Seule la deuxième solution est fiable, pour les agents comme pour les humains pressés un vendredi soir.
L'idée est ancienne en clean architecture : les règles d'architecture s'automatisent. Les agents nous obligent simplement à le faire.
Les tests d'abord, mais sans cérémonie
Le TDD/BDD fait partie de mon hygiène de développement depuis longtemps. Avec un agent, je n'y ai pas renoncé, mais j'ai changé le rythme : beaucoup moins de petits cycles RED/GREEN/REFACTOR, des cycles plus larges et plus directs. Je continue pourtant à faire écrire les tests en premier, pour trois raisons :
- c'est une reformulation du problème : le test dit autrement ce que le prompt demandait, et les écarts de compréhension apparaissent tôt ;
- cela évite les trous de couverture : on n'écrit pas les tests après coup en fonction de ce que le code fait déjà ;
- cela donne à l'agent un moyen de vérifier lui-même son code.
Les avis divergent. Willison recommande le red/green TDD : écrire le test, le voir échouer, puis implémenter. Böckeler, à l'inverse, a mesuré l'effet sur des tâches simples : pas de différence nette avec ou sans TDD, des solutions sans TDD plutôt mieux classées, et au moins trois fois plus de tokens. Elle a arrêté de demander le test-first à ses agents.
Son raisonnement se tient : le red/green ne prouve rien quand c'est l'agent qui écrit le test et constate l'échec, puisque personne ne vérifie que l'échec a lieu pour la bonne raison. Et une bonne partie des bénéfices du TDD (gérer la peur, avancer à petits pas, subir la friction de la conception) est propre à l'humain. Son expérience reste réduite (des tâches Python greenfield, une qualité jugée par un modèle), et elle n'a pas testé le cas où l'humain écrit lui-même les scénarios. Je n'y vois donc pas la preuve que j'ai tort, mais de quoi préciser ce que je garde : pas la cérémonie, ses fonctions.
Sa conclusion rejoint d'ailleurs mon expérience : mieux vaut surveiller les résultats que dicter la méthode. Elle propose les tests de mutation, qui montrent si un test détecterait réellement une régression, plutôt que d'imposer un rituel en espérant.
C'est aussi pourquoi je relis les tests avant le code. Ils sont la partie du diff qui dit ce que le système est censé faire.
Le vrai sujet : la dette cognitive
C'est la partie la plus discutée par les praticiens, et la moins visible dans les guides.
Willison le résume ainsi : écrire du code ne coûte presque plus rien, ce qui bouleverse nos intuitions. Mais la compréhension, elle, n'est pas devenue gratuite. Un fil Hacker News décrit des équipes qui reçoivent chaque semaine des quantités de code qui marche à peu près, sans pouvoir le relire sérieusement. Une étude qualitative récente parle de « dette de compréhension » : les agents produisent des changements plus vite et en lots plus gros que les relecteurs ne peuvent les inspecter.
Tout le monde n'est pas d'accord. Pour certains, « dette cognitive » est un mot-valise qui désigne un workflow mal construit (documentation absente, tests manquants, onboarding raté). Pour d'autres, le vrai problème est la qualité du code généré, donc la dette technique classique.
Mon avis : les deux ont raison, et c'est la discussion que j'ai avec mes clients depuis des années. Une dette cognitive est une dette technique que personne n'a encore identifiée. Les agents ne changent pas sa nature, seulement la vitesse à laquelle elle s'accumule.
Addy Osmani (qui travaille sur Claude Code chez Anthropic) donne une image qui fait mouche : avec un agent, le relecteur est souvent « le premier humain à voir ce code », car le raisonnement de l'agent est jeté une fois le diff produit. Sa piste : capturer l'intention et les alternatives écartées dans un journal de décisions attaché à la PR. Steve Yegge va dans le même sens avec Beads, un journal versionné dans Git qui garde le « pourquoi » des changements (un projet qu'il promeut lui-même, donc à prendre comme une illustration). Les ADR font la même chose depuis longtemps.
Les remèdes restent donc classiques : des changements petits et liés à une intention claire, des décisions écrites, une revue centrée sur l'architecture et le comportement, et une règle simple, ne pas fusionner ce qu'on ne sait pas expliquer.
La revue devient le goulot
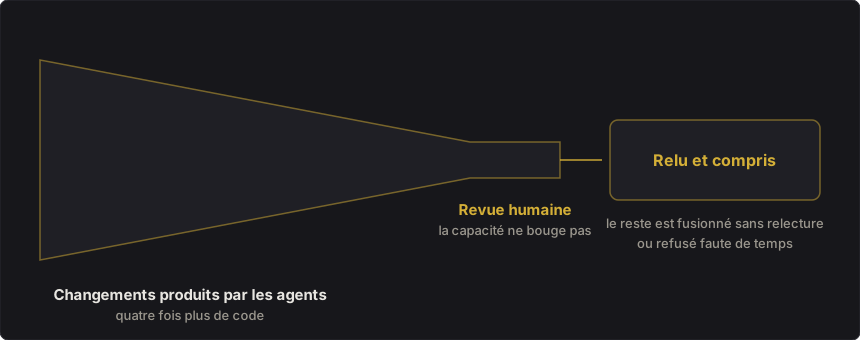
Avant, écrire coûtait plus cher que lire. Ce rapport s'inverse. Osmani rassemble des mesures récentes, avec une réserve qu'il signale lui-même : elles viennent surtout d'éditeurs d'outils. GitClear observe environ quatre fois plus de code produit par les utilisateurs quotidiens d'IA, pour un gain réel d'environ 12 %. Faros, sur 22 000 développeurs, relève 31 % de PR fusionnées sans aucune revue en plus. Personne n'a décidé d'arrêter de relire : le volume a décidé à notre place.
Ses recommandations ressemblent à du bon sens d'ingénieur :
- Trier par risque : un changement de configuration mérite un linter, un chemin de paiement mérite le grand jeu.
- Garder les PR petites, car un diff énorme est refusé ou approuvé sans lecture.
- Lire les tests modifiés d'abord : un agent peut « réparer » un test en réécrivant l'assertion pour coller au comportement cassé.
- Mettre l'humain « sur la boucle » plutôt que « dans la boucle » : échantillonner et auditer, pas lire chaque ligne.
La revue par IA est utile pour dégrossir, mais elle ne remplace pas la compréhension. Quand un modèle relit le code d'un autre modèle, ils ont tendance à se tromper de la même façon : ce que l'un ne voit pas, l'autre ne le voit pas non plus. Son « looks good » est sans doute sincère, il ne vaut pas celui d'un humain qui a compris.
Tout doit pouvoir se défaire
Pour savoir quelle autonomie laisser à un agent, je me pose une seule question : que se passe-t-il si c'est faux ? Si la réponse est « je jette la branche », il peut travailler sans surveillance. Si c'est « une migration est partie en production », certainement pas. La branche dédiée est le minimum, et git worktree va plus loin : chaque agent reçoit son propre répertoire de travail, une paillasse jetable sans risque pour le reste.
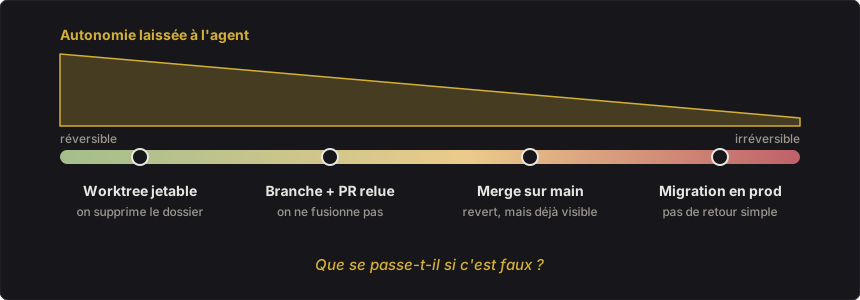
C'est ce qui rend le parallélisme possible, mais il a sa limite. Un praticien qui fait tourner trois à cinq agents depuis des mois conclut que la décomposition des tâches compte plus que leur nombre. Des consignes vagues donnent autant d'interprétations que d'agents, et deux agents dans le même répertoire finissent par s'écraser. Le multi-agent sert à paralléliser des problèmes indépendants, pas à remplacer une conception qu'on n'a pas faite.
Sécurité : des tests verts ne suffisent pas
Des chercheurs ont montré que des agents peuvent produire des patchs qui passent tous les tests tout en contenant une faille, que la faille ait été glissée volontairement par un attaquant ou introduite sans le vouloir. L'étude porte sur des scénarios précis, mais le principe est général : les tests ne prouvent que ce qu'ils couvrent.
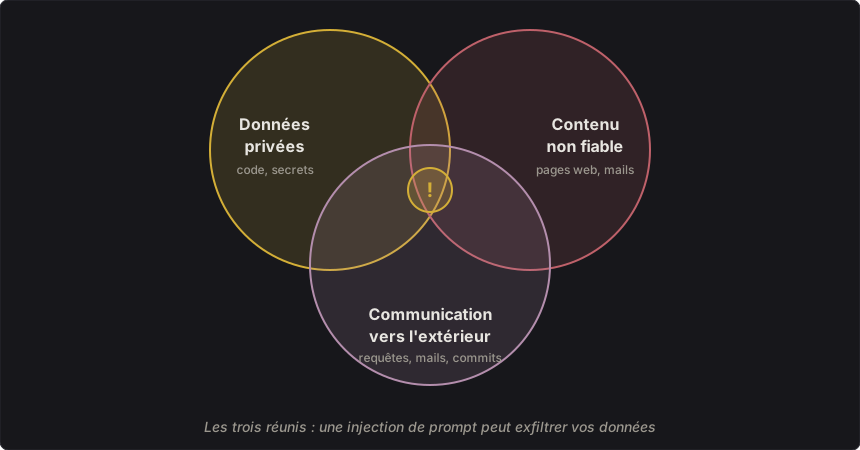
Willison propose un cadre utile, la lethal trifecta. Un agent qui a accès à des données privées, qui lit du contenu non fiable et qui peut communiquer vers l'extérieur peut être manipulé par injection de prompt pour exfiltrer ces données. Dès que les trois sont réunis, le risque est structurel. La réponse est celle de tout système sensible : sandbox, permissions minimales, secrets isolés, réseau restreint, journalisation. Et l'autonomie reste proportionnelle au risque : refactorer une fonction pure ne demande pas les mêmes garde-fous que toucher à l'authentification.
Ce que ça dit de notre métier
Avec les agents, les bonnes pratiques sont restées les mêmes. Ce qui a disparu, c'est la possibilité de s'en passer. Une équipe sans tests fiables, sans architecture explicite et sans discipline de revue pouvait survivre avec des humains qui compensent avec leurs petites mains. Avec des agents capables de produire dix fois plus de code, elle accumule dix fois plus vite sa dette.
La bonne question n'est plus « quel est mon meilleur prompt ? » mais « quel environnement ai-je construit pour que mon agent, et mes collègues, puissent réussir ? ». Ça ressemble beaucoup plus à de l'ingénierie qu'à de la magie.
Boileau le disait déjà, et j'en parlais dans J'ai une dette technique et c'est mon choix :
Hâtez-vous lentement, et sans perdre courage, Vingt fois sur le métier remettez votre ouvrage — Boileau, L'Art poétique
Avec des agents qui vont dix fois plus vite, c'est devenu un conseil d'ingénieur.
Sources : Simon Willison, Agentic Engineering Patterns · Birgitta Böckeler, TDD inside the agent loop et Context Engineering for Coding Agents · Addy Osmani, Agentic Code Review · Google Research, règles d'agents et patchs corrects mais vulnérables