

Intégrer l'IA sans jeter l'argent par la fenêtre de contexte
Dans un pipeline qui enchaîne des appels à un LLM, l'étape qui fait le plus d'appels n'est pas forcément celle qui coûte le plus cher. Et chaque jeton envoyé dans la fenêtre de contexte a un coût : en argent chez un fournisseur d'API, en latence, et en calcul, donc indirectement en énergie. Ce coût grimpe vite avec la taille des données.
Or une partie de cette dépense peut être évitée : des contenus renvoyés à l'identique, des étapes rejouées, des questions que du code aurait réglées seul.
Repérer et supprimer ce gaspillage n'est pas une affaire de bonnes intentions : la frugalité est de l'ingénierie de performance, avec les mêmes réflexes que d'habitude. Voici ceux que j'ai retenus en développant RetroDoc, un outil qui reconstruit la documentation d'un dépôt Git à partir de son code (j'en parlais dans La dette de documentation). Les principes valent pour d'autres projets de ce genre, mais les gains que je cite dépendent de mon projet, de mon modèle et de mes données : RetroDoc ne sert qu'à les illustrer.
Avant d'optimiser, trouvez ce qui pèse vraiment
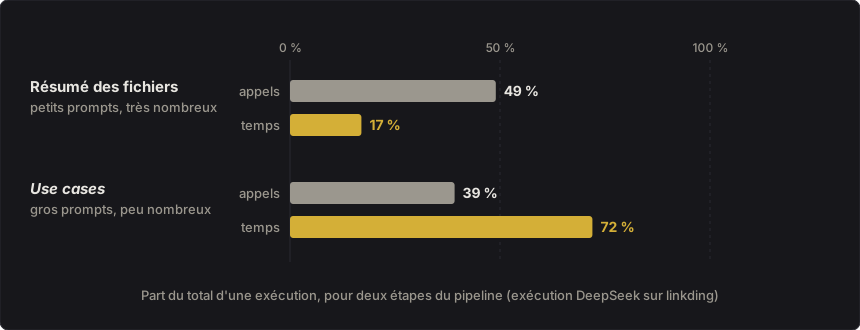
Ne vous fiez pas à l'intuition. Appels, jetons et temps ne se répartissent pas de la même façon entre les étapes d'un pipeline, et on est toujours tenté de s'attaquer à celle qui fait le plus d'appels.
Chez moi, une étape de résumé fait 45 à 55 % des appels sur une application d'environ 180 fichiers. La cible idéale ! Sauf que ses prompts sont petits : elle ne pèse que 9 à 17 % du temps. L'essentiel se passe dans une autre étape : 61 % du temps en local (72,6 minutes sur 118,4), 72 % avec DeepSeek. La supprimer aurait économisé des appels, pas des heures.
Knuth le disait déjà en 1974, bien avant les LLM :
It is often a mistake to make a priori judgments about what parts of a program are really critical, since the universal experience of programmers who have been using measurement tools has been that their intuitive guesses fail. — Donald Knuth, Structured Programming with go to Statements
Pour ne pas avoir à deviner, faites afficher cette répartition à chaque exécution : un récapitulatif des appels, des jetons et du temps, étape par étape et modèle par modèle. Si votre fournisseur les expose, séparez les jetons d'entrée des jetons de sortie (ils ne pèsent pas pareil), repérez ceux qu'un cache de prompt a déjà traités, et comptez à part les appels échoués ou rejoués. Une étape peut en effet consommer beaucoup de jetons sans être lente, ou l'inverse.
Deux précautions rendent ce récapitulatif fiable. Ne comptez que les jetons que le serveur rapporte, sans les estimer à partir du nombre de caractères, quitte à signaler que le total est sous-estimé. Et si vous affichez un prix, datez-le : les tarifs changent plus vite que votre code, et une seule grille ne vaut pas pour plusieurs modèles. À défaut, donnez au moins les volumes de jetons, qui permettent de le calculer.
Réutilisez ce qui est déjà fait
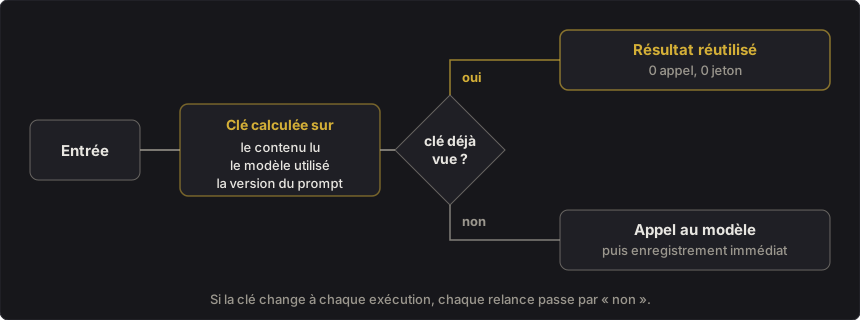
Si les données qu'un traitement reçoit n'ont pas changé depuis la dernière exécution, inutile de rappeler le modèle : on réutilise le résultat déjà obtenu. Associez à chaque résultat une clé calculée sur ce dont il dépend (le contenu des documents lus, le modèle utilisé, la version du prompt) et sautez ce qui est à jour. La clé doit couvrir tout ce qui peut changer le résultat : selon votre système, cela peut inclure aussi les paramètres de génération ou le format de sortie attendu.
Enregistrez après chaque appel, pas à la fin : une exécution interrompue reprend alors où elle s'était arrêtée, au lieu de jeter le travail déjà fait.
Un cache n'est utile que si ses clés sont stables. Dans mon cas, une étape intermédiaire n'était pas déterministe : ses identifiants changeaient à chaque exécution, toutes les clés en aval aussi, et une relance « sans changement » refaisait tout. Le tonneau des Danaïdes ! Cherchez ce qui, dans votre pipeline, rend vos clés instables, et décidez à l'avance ce qui invalide le cache : si changer un prompt ne le vide pas, vous servirez de vieux résultats sans le savoir. Et gardez en tête qu'avec un modèle non déterministe, réutiliser le cache, c'est accepter la réponse de la première génération : une mauvaise réponse reste figée tant que l'entrée ne change pas, ou que vous ne videz pas le cache.
Lisez chaque document une seule fois
Dans un pipeline à plusieurs étapes (extraction, classification, résumé, vérification), le même document finit souvent dans plusieurs prompts, un par question. Le modèle relit donc plusieurs fois le même texte.
Deux remèdes. Poser les questions ensemble dans un seul appel, avec une réponse structurée qui les couvre toutes. Ou garder le contenu commun en tête de prompt et profiter du cache de prompt si votre fournisseur en propose (il évite de retraiter un début de prompt déjà envoyé). Ils n'ont pas les mêmes gains : le premier change la façon d'interroger le modèle, le second dépend de ce que votre fournisseur propose et facture.
Pour savoir si le jeu en vaut la chandelle, mesurez d'abord le recouvrement : un petit script qui compte, pour chaque étape, les documents qu'elle lit, et ce que les étapes ont en commun. Chez moi, deux étapes de RetroDoc lisaient les mêmes fichiers : 36 % des caractères qu'elles lisaient portaient sur des fichiers lus deux fois. En les fusionnant, j'ai supprimé un tiers des appels et des jetons sur une application réelle.
Mais fusionner n'est pas gratuit pour la qualité. L'ordre des questions compte : en plaçant la question sur les entités en premier, le modèle ne retrouvait plus qu'un seul point d'entrée de l'application (route, commande…) sur une quinzaine. Et sur une petite bibliothèque de neuf fichiers, la lecture fusionnée retrouvait moins de points d'entrée que les deux lectures séparées. Gardez donc l'ancien chemin disponible, et comparez.
Réservez le modèle à ce qui est ambigu
Si du code peut répondre avec certitude, qu'il réponde. Beaucoup de contrôles qu'on délègue à un LLM relèvent de la vérification mécanique : la source citée existe-t-elle, la valeur annoncée apparaît-elle dans le texte, le JSON respecte-t-il son schéma, le chemin existe-t-il ? Passez chaque réponse du modèle par ces contrôles, et ne le rappelez que pour les cas douteux. Un tel contrôle ne doit valider que ce qu'il peut établir mécaniquement : il conclut « valide », « invalide » ou « indéterminé », et ce dernier cas part au modèle.
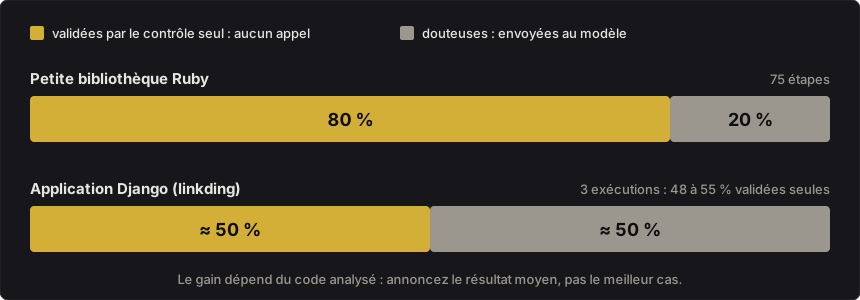
Chez moi, chaque étape d'un use case (un scénario fonctionnel décrit pas à pas) cite les lignes de code qui la justifient, et les faire vérifier par un LLM représentait un appel sur cinq. Une simple recherche de texte règle une bonne part des cas : le contrôle vérifie que les lignes citées existent et que les noms mentionnés par l'étape s'y trouvent, et n'envoie au modèle que le reste.
Sur une petite bibliothèque, 80 % des étapes passent seules. Mais un use case n'est réglé que si toutes ses étapes passent : 6 sur 13, ce qui ramène cette vérification de 8 à 4 appels. Sur une application plus grande et plus dynamique, seule la moitié des étapes passent seules, et le reste part encore au modèle. Le gain dépend donc de votre code : annoncez le résultat moyen, pas celui de votre meilleur cas.
Ce contrôle a aussi sa limite : trouver un nom dans le code ne prouve pas que la fonction fait ce que la documentation lui attribue. Ses scores sont donc un peu optimistes (quand on demande aussi son avis au modèle, il est plus sévère), et on fait relire un échantillon par le modèle pour garder la mesure honnête.
Le cas « indéterminé » est le plus facile à oublier. Mon contrôle comptait d'abord comme valide une affirmation qui ne nommait rien de vérifiable, puisque rien ne la contredisait : 93 % de réussite, ramenés à 80 % après correction. Un thermomètre qui affiche toujours 37 °C ne signale jamais de fièvre.
Produisez une fois, consultez autant que vous voulez
Séparez la production de la consommation. Si le résultat d'un traitement lourd sert à de nombreuses questions, exposez-le par un chemin de lecture léger (fichiers statiques, index, API en lecture seule) plutôt que de reposer la question au modèle à chaque fois. Le travail se fait une fois, à la génération.
Dans mon cas, les documents générés sont servis aux agents de code par un serveur en lecture seule, sans clé d'API ni modèle : une recherche lexicale écrite à la main suffit, sans embeddings tant qu'on n'a pas montré qu'elle échoue sur le vocabulaire du domaine. Pour le montrer, testez-la sur quelques questions représentatives, avec les synonymes et les formulations indirectes que vos utilisateurs emploieront vraiment, et n'ajoutez des embeddings que si elle échoue de façon durable. Les réponses sont déterministes. Elles préviennent aussi quand un fichier cité a été modifié depuis la génération : un résultat produit une fois peut devenir faux, et le lecteur doit le savoir.
Laissez l'utilisateur plafonner, et dites ce qui reste dehors
Un pipeline LLM doit pouvoir être borné : un plafond sur le nombre de documents, un échantillon pour les vérifications lourdes, une estimation affichée avant de lancer. Savoir « ça va faire 300 appels » avant de commencer change la décision de lancer ou non.
Mais la limite doit rester un choix visible. Chez moi, l'utilisateur peut limiter l'analyse aux N fichiers les mieux classés, et le rapport liste tout ce qui n'a pas été analysé. Attention : plafonner le périmètre ne plafonne pas le travail demandé au modèle, car un fichier long demande plus d'appels qu'un fichier court. Je n'ai que le plafond de périmètre et l'estimation avant lancement ; si votre budget est une contrainte ferme, plafonnez aussi les appels ou les jetons.
J'ai refusé un plafond automatique : abandonner des entrées sans le dire fausse le résultat, et masquerait ici de la dette de documentation, exactement ce que l'outil doit révéler. Une borne silencieuse est une dégradation, pas une optimisation.
Mesurez avant d'activer une optimisation
C'est le conseil qui m'a le plus servi. Une optimisation dont on ne connaît pas l'effet sur le résultat n'en est pas encore une : un prompt plus court ou un appel en moins qui dégrade silencieusement le résultat déplace le problème, il ne le supprime pas. Mesurez donc la qualité en même temps que le gain, avec une référence si vous en avez une, et sur plusieurs exécutions, car la variance d'un LLM peut être aussi grande que l'effet que vous cherchez.
Un exemple. Pour alléger les prompts, j'ai essayé de ne montrer au modèle que la signature et les premières lignes de chaque méthode, au lieu du code complet. Résultat : des prompts 42 % plus petits. Sur le papier, c'est un gain net.
Mais en regardant aussi le résultat, le tableau change : le modèle retrouve moins d'entités (les objets métier du code, comme un utilisateur ou une commande), 77 à 94 par exécution contre 103 à 132 avec le code complet, dans les trois exécutions. Sans cette seconde mesure, j'aurais activé l'optimisation par défaut et perdu de l'information sans m'en apercevoir. Elle reste donc une option, et c'est un avantage : chaque projet règle le curseur selon ses moyens, la qualité de ses données, la puissance de son modèle, le temps dont il dispose. Un projet aux données propres et au modèle puissant n'a pas les mêmes besoins qu'un projet qui tourne sur un petit modèle local.
La suite logique est de mesurer ce qu'on perd exactement : compter des entités donne une quantité, pas une qualité. Avec une liste annotée à la main, on peut calculer la précision (ce que le modèle a trouvé est-il juste ?) et le rappel (a-t-il trouvé tout ce qu'on attendait ?).
J'ai appliqué la même démarche à une autre approche, qui réduit de 55 % le nombre d'appels sur une grosse application mais donne de moins bons résultats sur une petite. Là aussi, c'est un réglage plutôt qu'un choix imposé : à chacun de l'adapter à la taille de son projet.
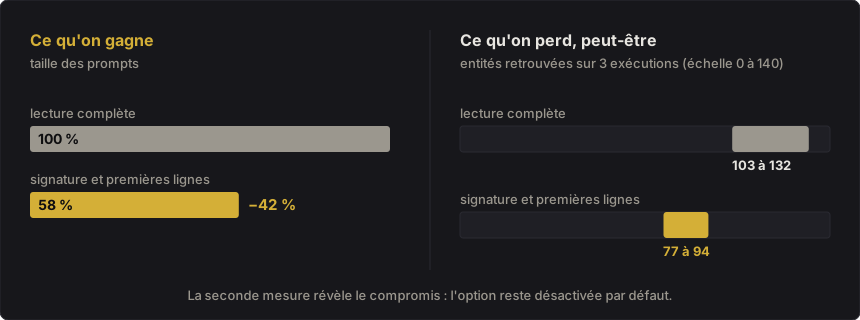
Ces chiffres viennent d'un modèle local, de peu de dépôts et de trois exécutions par réglage : ils valent pour mon projet, pas forcément pour le vôtre. C'est précisément pourquoi il faut les mesurer chez soi.
Concevoir juste ce qu'il faut
Rien de spectaculaire là-dedans : des compteurs, des clés de cache stables, des contrôles qui évitent un appel, des limites choisies par l'utilisateur, et l'habitude de noter ce qu'on a mesuré avec ce qu'on n'a pas pu mesurer. Chaque appel évité est un choix qu'on peut justifier, et chaque appel gardé aussi.
Il semble que la perfection soit atteinte non quand il n'y a plus rien à ajouter, mais quand il n'y a plus rien à retrancher. — Antoine de Saint-Exupéry, Terre des hommes
À condition de savoir ce qu'on retranche. Sans mesure, on coupe à l'aveugle.