Le cordonnier bien chaussé : un outillage d'agent qui se mesure lui-même
Un outillage pour agents de code tient-il ses promesses ?
Dans La qualité à l'ère agentique : un outillage sur mesure, je présentais Cardinal, l'outillage que j'ai construit pour faire travailler des agents sur mes projets : des specs reliées aux tests, des gates (des contrôles qui bloquent au lieu de conseiller), un seul arrêt de validation humaine.
Reste une question qu'on pose rarement à ce genre d'outil : est-ce que ça marche vraiment ? Les règles qu'on donne à un agent sont le plus souvent validées « au feeling ». (J'en parlais dans L'agentic coding ne réinvente pas l'ingénierie logicielle.)
Cardinal, lui, se mesure. Et il a été construit avec lui-même, ce qui ne gâche rien.
Construit avec lui-même
On dit que les cordonniers sont les plus mal chaussés. Cardinal, lui, a été construit avec Cardinal : chaque issue est passée par sa procédure, et chaque commit par sa propre gate de revue. En une semaine, du 24 au 30 octobre : 121 issues closes et déjà une version 1.1 avec son changelog. Le travail à venir a même sa feuille de route, découpée en jalons qui deviennent des issues le moment venu.
Cette récursion a un effet précieux : l'outil révèle ses propres défauts en servant.
Un jour, la gate de revue refuse un commit qui ne touchait que des issues. Un fichier de spec inconnu venait d'apparaître dans le répertoire de travail : le brouillon d'une autre session, lancée en parallèle… dans le même répertoire. Ça commence bien. En remontant le fil, l'agent constate que, sur 188 sessions de traitement d'issue dans cinq projets, aucune n'avait jamais utilisé les worktrees (des copies de travail séparées du dépôt) prévus pour le travail en parallèle. La fonctionnalité existait, sa spec aussi. Rien ne conduisait l'agent à s'en servir.
La première correction a confié à l'agent la création du worktree. L'usage a vite montré que Claude Code y bloque alors des dizaines de commandes ordinaires. On a fini à l'opposé de la piste de départ : c'est l'humain qui ouvre le worktree, et seulement pour du travail parallèle.
La récursion a aussi un revers : elle renforce les biais. Un outil construit en se développant lui-même devient excellent… pour développer des outils en Rust qui se vérifient eux-mêmes. Mes autres projets, dont RetroDoc, servent de contre-épreuve, mais ce sont encore des projets à moi.
Deux boucles
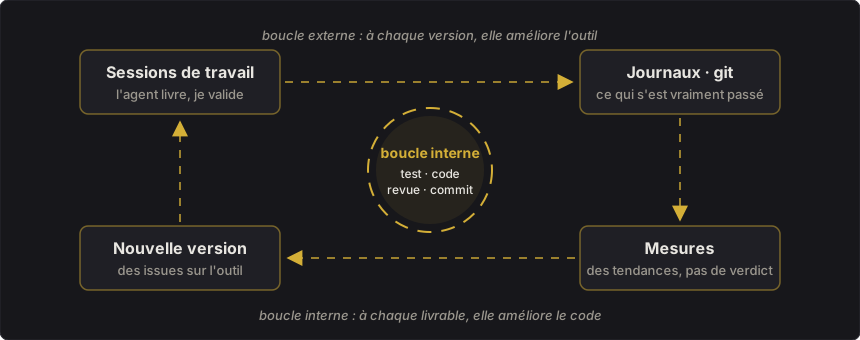
Cardinal fait tourner deux boucles. La boucle interne tourne à chaque livrable : test rouge puis vert, linter, contrôle des specs, revue. Elle améliore le code. La boucle externe tourne à chaque version de l'outil : des programmes lisent les journaux des sessions Claude Code et l'historique git, puis mesurent mes interventions, les règles enfreintes, les remarques de revue, les correctifs après clôture. Elle améliore l'outil.
Un exemple : la médiane, par session, des messages que je tape, selon la version de Cardinal en service.
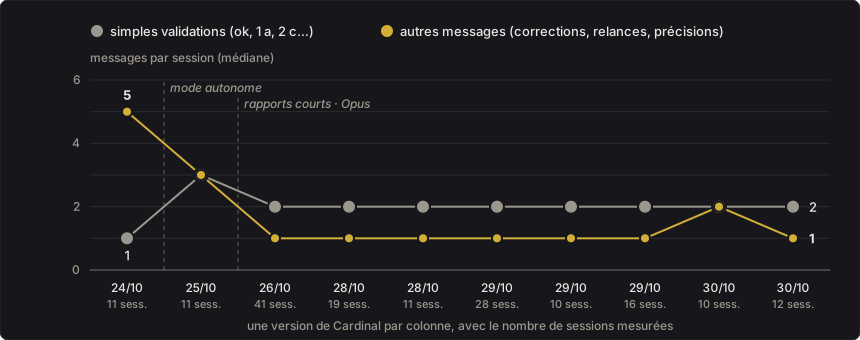
Les validations augmentent un peu, ce qui est attendu avec l'arrêt de validation unique. Les autres messages (corrections, relances, précisions) passent de 5 à 1, et y restent sur les huit versions suivantes, à une exception près. Pas de quoi crier victoire pour autant. La première baisse est arrivée avec le mode autonome, quand les sessions tournaient encore surtout sur Sonnet. La seconde coïncide avec le passage à Opus : impossible de dire ce qui revient aux rapports courts. Et cela mesure mes interventions, pas la qualité du code livré. Un indice, pas une preuve.
Mesurer sans viser un chiffre
Mesurer expose à un piège que l'économiste Charles Goodhart avait repéré dès 1975, et que l'anthropologue Marilyn Strathern a résumé ainsi :
When a measure becomes a target, it ceases to be a good measure. — Marilyn Strathern, ‘Improving ratings’: audit in the British University system, European Review, 1997
J'y suis tombé deux fois.
La première, avec la gate de revue. Chaque revue de son hook (un script que Claude Code exécute autour des actions de l'agent) trouvait une commande shell qui lui échappait, et chacune devenait une exigence. En deux jours, environ un tiers des issues closes jusque-là lui étaient consacrées. Une décision d'architecture y a mis un terme : les gates attrapent les erreurs d'un agent coopératif, pas les contournements délibérés.
La seconde, avec les preuves à la frontière. Un avertissement signalait les exigences prouvées seulement par des tests internes, et l'agent s'est mis à écrire des tests de bout en bout, longs et fragiles, pour le faire taire. Il ne trichait pas : il optimisait ce qu'on lui montrait. L'avertissement est resté une indication, pas une cible à ramener à zéro.
L'évaluation, elle, ne transforme jamais un chiffre en verdict « réussi » ou « échoué ». Chaque changement de l'outil peut annoncer l'effet qu'il attend, et le rapport dit s'il l'a eu, ou s'il ne peut pas conclure parce que le modèle ou les projets ont changé entre-temps. Les deux verdicts enregistrés à ce jour sont d'ailleurs… « non concluants ». C'est la limite d'une mesure qui observe sans contrôler. Prochaine étape, déjà sur la feuille de route : rejouer un même jeu de tâches avec deux variantes de l'outil, pour passer de l'observation à l'expérience.
Des chiffres pas toujours flatteurs
Et c'est tant mieux. Sur Cardinal lui-même, les premières issues mesurées ont été suivies d'une dizaine de commits de correction chacune, les plus récentes de moins d'un. Belle courbe ! Sauf que les plus récentes ont eu quelques jours de moins pour révéler leurs défauts. On jugera dans un mois.
La mesure sert aussi à enterrer une bonne idée. Un hook devait rappeler à l'agent de répondre dans ma langue entre deux actions, pas seulement à la fin de son tour. Ses tests passaient tous. Mesuré en session réelle, le rappel n'arrivait presque jamais : Claude Code déclenche le hook avant d'avoir écrit le texte qu'il devait juger. Des tests verts, et aucun effet. On l'a retiré.
Creuser le tunnel par les deux bouts
Reste un cas que Cardinal traite mal : le code existant. Une capacité qui n'a jamais été modifiée par une issue n'a pas de spec, et la procédure qui en déduit une du code ne peut énoncer que ce qui est déjà testé.
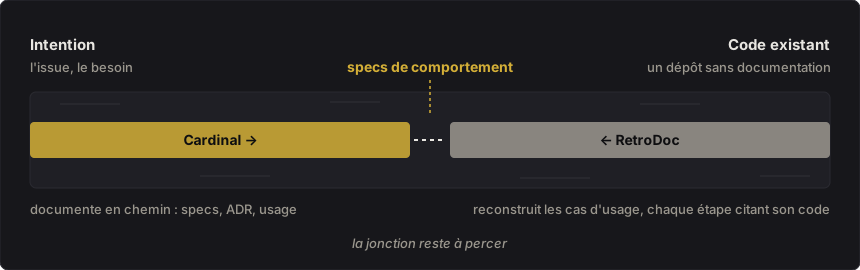
RetroDoc creuse dans l'autre sens. Il part d'un dépôt existant et en reconstruit la documentation fonctionnelle, chaque étape citant le code qui la justifie. (C'est ma réponse à la dette de documentation.)
RetroDoc remonte du code vers le comportement. Cardinal descend de l'intention vers le code, en documentant en chemin. Les deux se rejoignent sur les specs de comportement. Les relier reste une perspective, mais le chemin est tracé : récupérer la connaissance perdue, puis cesser de la perdre.
Et chez vous ?
À quoi sert cette boucle, au fond ? À augmenter la confiance qu'on peut accorder à l'agent. Par des preuves qui se renforcent, et par des mesures qui disent s'il dérape moins.
Pas besoin de Cardinal pour s'y mettre. Vos agents laissent déjà des journaux de session, et votre dépôt garde l'historique de ce qu'ils ont livré : il suffit de commencer à les lire. (Et si vous voulez de l'aide pour outiller vos équipes, c'est par ici.)
L'équipe Applied AI d'Anthropic ne dit pas autre chose quand elle conseille, pour faire évoluer un agent, de :
measure, change one thing at a time, and keep what holds up. — Diane Sarkis, Building agents: when to fold subagents into your main agent loop
Sources : Cardinal · RetroDoc · Loi de Goodhart · Diane Sarkis, Building agents: when to fold subagents into your main agent loop