La qualité à l'ère agentique : un outillage sur mesure
Quand un agent écrit le code, d'où vient la confiance ?
Pas de la relecture de chaque diff, en tout cas. Au rythme où un agent produit, on ne fait plus que ça, et on finit par valider sans lire. Pas non plus d'une pile de documents rédigés avant la première ligne de code. Il faut les relire aussi, et ils vieillissent dès le lendemain.
Ma réponse est un outillage construit au fil de mes projets : Cardinal. (Un outil pour Claude… Claudia Cardinale. Je n'ai pas pu m'en empêcher.)
Et ma conviction : un outillage taillé sur mesure pour le projet sert mieux que le prêt-à-porter d'un framework générique. Voici ce que fait Cardinal. (Comment il s'est construit avec lui-même, et ce que ses mesures en disent, c'est l'objet d'un second article.)
Au commencement était le copier-coller
Au départ, il n'y avait pas d'outil. Juste des instructions, des procédures et des hooks (des scripts que Claude Code exécute autour des actions de l'agent), recopiés d'un projet à l'autre. Chaque amélioration devait être reportée à la main dans les autres projets, en adaptant les chemins et les formulations. (Le genre de corvée qu'on remet toujours à demain.)
La première étape de Cardinal a donc été de tout regrouper dans un dépôt, avec un petit binaire Rust qui synchronise les projets.
Un framework part d'une méthode et vous demande de l'adopter.
Cardinal, lui, part de problèmes observés : chaque règle existe parce que quelque chose a mal tourné.
L'agent a signé un commit « Co-Authored-By: Claude » ? Un hook le refuse.
Il a rendu la main avec des avertissements de clippy ? Un hook le renvoie corriger.
Il a commité sans revue ? Le commit est refusé.
Rien de révolutionnaire, et c'est voulu.
Le signal plutôt que la paperasse
La plupart des outils de Spec Driven Development soignent ce que l'agent reçoit : des documents de conception, rédigés avant le code. Cardinal soigne ce que l'agent observe : des signaux qui lui disent s'il a réussi.
Je l'écrivais dans L'agentic coding ne réinvente pas l'ingénierie logicielle : un agent est une boucle, et la boucle ne vaut que par ce qu'elle observe. Donnez à un agent une spec moyenne et un bon signal, il finira par converger. Donnez-lui une spec parfaite et aucun signal, il vous livrera quelque chose de plausible. Plausible, pas juste.
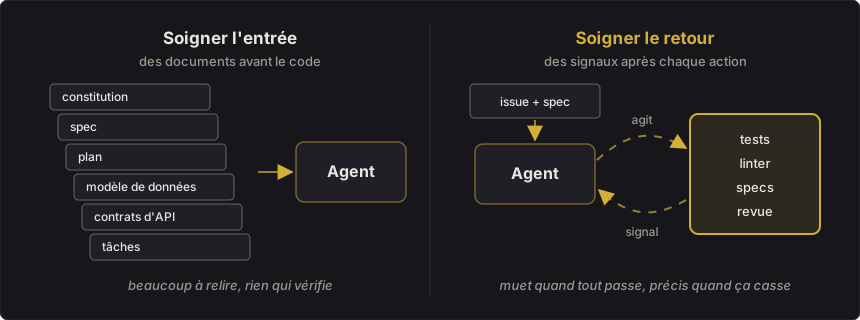
Pour produire ces signaux, pas besoin d'inventer une méthode. Cardinal reprend des pratiques que tout développeur connaît :
- Une issue par changement : un fichier Markdown que l'agent complète (compréhension, plan, suivi de chaque livrable).
- Le TDD : le test d'abord, et l'agent consigne son échec avant d'écrire le code.
- Le formatage et le linter : après chaque modification pour l'un, avant que l'agent rende la main pour l'autre.
- La revue de code : faite par un modèle, exigée par un hook git
pre-commit. Pas de revue enregistrée, pas de commit. - Les ADR : le pourquoi des choix, que l'agent lit avant de toucher au code concerné.
La différence, c'est que ces contrôles ne sont pas des consignes que l'agent pourrait oublier après quelques heures de session. Ce sont des programmes qui bloquent, des gates. Ils restent muets quand tout passe et compacts quand ils échouent : leur sortie est faite pour être lue par un modèle.
Autre principe, peut-être le plus structurant : une session, une issue. L'agent ne garde en contexte que son issue, isolé des autres travaux en cours. (Le développeur qu'on n'interrompt jamais. Le rêve !) Et comme il consigne dans l'issue sa compréhension, son plan, ses décisions et le suivi de chaque livrable, rien ne se perd quand la session se termine. Les sessions suivantes repartent de ces documents, et de l'intention qui les a motivés.
Ça rejoint ce que décrit Diane Sarkis (Anthropic) : une seule boucle d'agent, avec des skills et des outils chargés à la demande, fait souvent mieux qu'une armée de sous-agents qui se renvoient des résumés, où l'information se perd. Cardinal fait le même pari. L'isolement vient du découpage en issues, pas de la délégation, et garder un sous-agent seulement là où une mesure le justifie est même un jalon de sa feuille de route.
Reste les specs, là où l'approche diffère le plus. Pas de spec par fonctionnalité, qu'on cesse de lire une fois livrée : Cardinal en tient une par capacité (« la gate de revue », « la synchronisation »…), amendée par chaque issue qui la change. Chaque exigence porte un identifiant et ne contient qu'une seule obligation :
- **LNG-1** (deterministic) The hook must exit 0 and print nothing
  when the event sets `stop_hook_active`.
Le test qui la prouve la cite :
// spec: LNG-1
#[test]
fn the_hook_lets_go_once_it_sent_the_agent_back() {
    // ...
}
Un contrôle échoue si une exigence acceptée n'est citée par aucun test. Un autre signale les formulations floues (« should », « etc. », « fast »…) avant la validation. Ce qu'aucun test ne peut prouver n'entre pas dans la spec, et ce qui n'est pas spécifié relève de la liberté d'implémentation. On l'assume.
La spec est le code source, le LLM est le compilateur
Pendant des décennies, la chaîne a été : code source, assembleur, binaire. Qui relit encore l'assembleur produit par son compilateur ? Avec un agent, la chaîne devient : issue, spec, code. Alors à quoi bon tout relire ?
L'analogie a une faille, et il faut la regarder en face. Si on ne relit plus l'assembleur, c'est parce que le compilateur est digne de confiance : il est déterministe, il préserve la sémantique, et des suites de validation le vérifient depuis des décennies. Un LLM n'offre aucune de ces garanties. La confiance doit donc venir d'ailleurs : d'une vérification à chaque « compilation ».
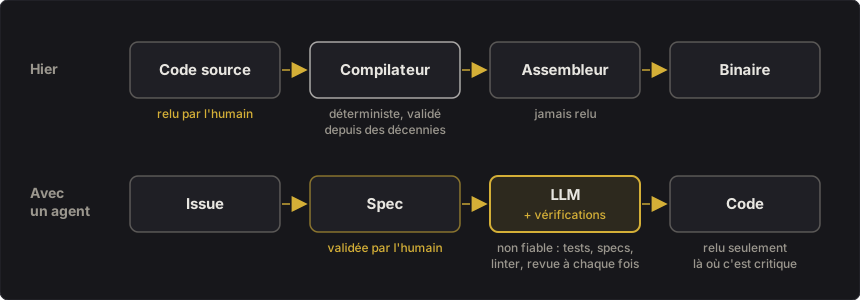
D'où ma réponse : on cesse de relire le code quand la vérification est assez forte pour remplacer la lecture. La relecture remonte vers la spec, que l'humain valide, et elle est automatisée pour le code. Au passage, une spec dont chaque exigence est prouvée par un test sert à la fois de cahier de recette et de documentation à jour. Et comme elle décrit un comportement plutôt qu'une architecture, elle permet en principe de réimplémenter le logiciel autrement.
En principe. Car les limites existent :
- Les vérifications ne sont pas indépendantes : la revue est faite par un modèle, les tests par l'agent lui-même, et deux modèles ont tendance à se tromper de la même façon. C'est pourquoi je relis les tests avant le code.
- Une spec est incomplète, le code ne l'est jamais : ce que la spec ne dit pas (un message d'erreur, un ordre de sortie), le modèle le décide arbitrairement. Et la loi de Hyrum (Hyrum Wright, Google) nous rappelle que des utilisateurs finiront par en dépendre.
- Le comportement ne couvre pas tout : performance, sécurité, maintenabilité échappent à une spec comportementale. Le code critique restera lu, comme on relit encore l'assembleur pour optimiser ou auditer.
- Réimplémenter suppose des tests boîte noire : un test unitaire Rust ne prouve rien pour une version en Go. Cardinal prouve donc de plus en plus ses exigences à la frontière du binaire, sans en faire un dogme quand un tel test serait lent ou fragile.
Juste assez de contrôle
Ce que j'apprécie le plus au quotidien, c'est le dosage. Assez de contrôle pour être rassuré, assez d'autonomie pour ne pas tomber dans la microgestion.
Le secret : placer les arrêts humains selon le risque, pas selon les phases.
L'agent prépare dans l'issue sa compréhension, la spec et le plan, puis s'arrête une seule fois pour validation.
Ses questions arrivent dans un tableau numéroté, avec des options et sa recommandation. On répond 1 a, 2 c, ou ok pour tout accepter.
Ensuite, il passe en mode autonome et enchaîne les livrables.
Ce que l'autonomie ne lève jamais : la revue de chaque livrable, une revue approfondie de l'ensemble, et l'interdiction de publier (git push), de supprimer ou de réécrire l'historique sans mon accord.
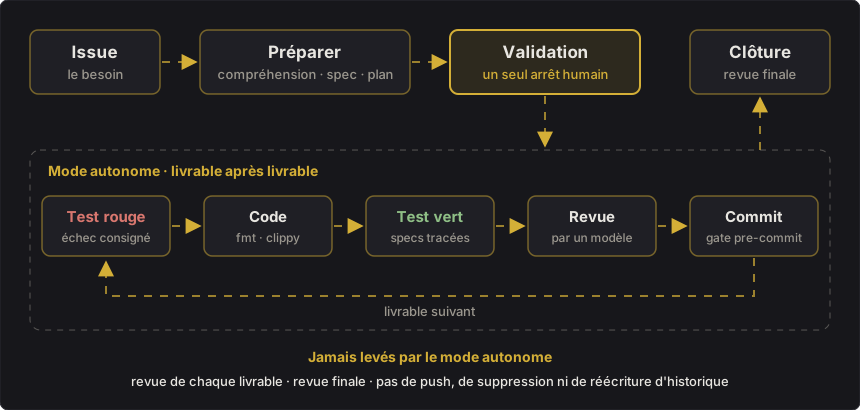
Autrement dit, la confiance vient des garde-fous exécutés, pas des validations répétées.
Deuxième ingrédient, moins visible : des rapports courts. Une règle chargée dans chaque session impose des tableaux et des listes, sans récit des étapes, sans répéter ce que le diff montre déjà. L'attention humaine est la ressource la plus rare de la boucle. Un rapport de quarante lignes à chaque livrable, on finit par le valider sans le lire. Autant dire qu'on ne contrôle plus rien.
Spec-kit et consorts
Le Spec Driven Development a ses outils, et les frameworks génériques répondent à d'autres situations que la mienne :
- spec-kit : une demi-douzaine de documents par fonctionnalité avant le code (spec, plan, modèle de données, contrats d'API, tâches), pensé pour une équipe et un projet neuf. Dans son flux de base, rien ne relie la spec aux tests.
- OpenSpec : des specs vivantes et un dossier par changement. Le plus proche de Cardinal, mais aucune gate ne bloque l'agent, et rien ne relie les specs aux tests.
- Kiro : un IDE avec exigences, conception, tâches et hooks. Le même esprit, dans un environnement fermé.
- BMAD : une équipe agile simulée par des personas. L'organisation est reproduite, la cérémonie aussi.
- Superpowers : un plugin Claude Code (TDD, plans, sous-agents, revue), proche dans le comportement, mais où tout passe par des consignes.
J'ai quand même emprunté une idée à spec-kit : quand l'agent rédige une spec, il doit écrire [NEEDS CLARIFICATION: …] là où il serait tenté de deviner.
Le sur-mesure, c'est aussi ça : prendre ce qui résout un problème rencontré, et laisser le reste.
Autre choix délibéré : Cardinal ne cible que Claude Code. Prendre en charge tous les agents du marché, c'est se limiter à ce qu'ils ont en commun : des fichiers Markdown et des consignes. Le syndrome du couteau suisse, qui fait tout, et rien très bien. En visant un seul agent, Cardinal peut s'appuyer sur ses hooks, qui refusent au lieu de conseiller.
Il a aussi ses limites. Il est né chez un développeur seul, sur des outils en Rust. Depuis sa version 1.0, il trace les specs dans les tests de n'importe quel langage, lance le linter et le formateur que le projet déclare, et laisse plusieurs personnes travailler sans se marcher dessus. Mais aucun projet ne l'utilise encore en équipe : c'est la contre-épreuve qui manque. Et il ne remplace pas le jugement : ses mesures ne valent que par la personne qui les lit.
Ce que ça change pour vos équipes
Ce que montre Cardinal ne tient pas à Cardinal. La qualité, à l'ère agentique, reste celle qu'on connaît : des tests fiables, des revues, des décisions écrites, des changements petits. Ce qui change, c'est qu'il faut l'outiller pour qu'un agent la respecte sans qu'un humain le surveille, et la mesurer pour savoir si l'outillage tient ses promesses.
Cardinal n'est donc pas fait pour être adopté tel quel. Il est taillé pour mes projets ; le vôtre ressemblera à vos projets, à vos risques et à votre équipe. Vous donner Cardinal, ce serait vous donner un poisson. Et le proverbe est connu :
Donne un poisson à un homme, il mangera un jour. Apprends-lui à pêcher, il mangera toute sa vie. — Proverbe
Vos agents produisent vite, mais vous hésitez à leur faire confiance ? Vos développeurs passent leurs journées à relire du code généré, ou ont cessé de le relire ? C'est ce que je vous aide à résoudre : livrer mieux avec des agents, sans perdre la main, et avec des développeurs à l'aise.
On part de vos projets et de vos incidents réels, et l'outillage suit. Je reste le temps que votre équipe sache pêcher seule.
Si le sujet vous parle, écrivez-moi !
Sources : GitHub spec-kit et sa méthode · OpenSpec · Kiro · BMAD-METHOD · Superpowers · Diane Sarkis, Building agents: when to fold subagents into your main agent loop · Hyrum Wright, Hyrum's Law · Cardinal